// Data & Database Validation
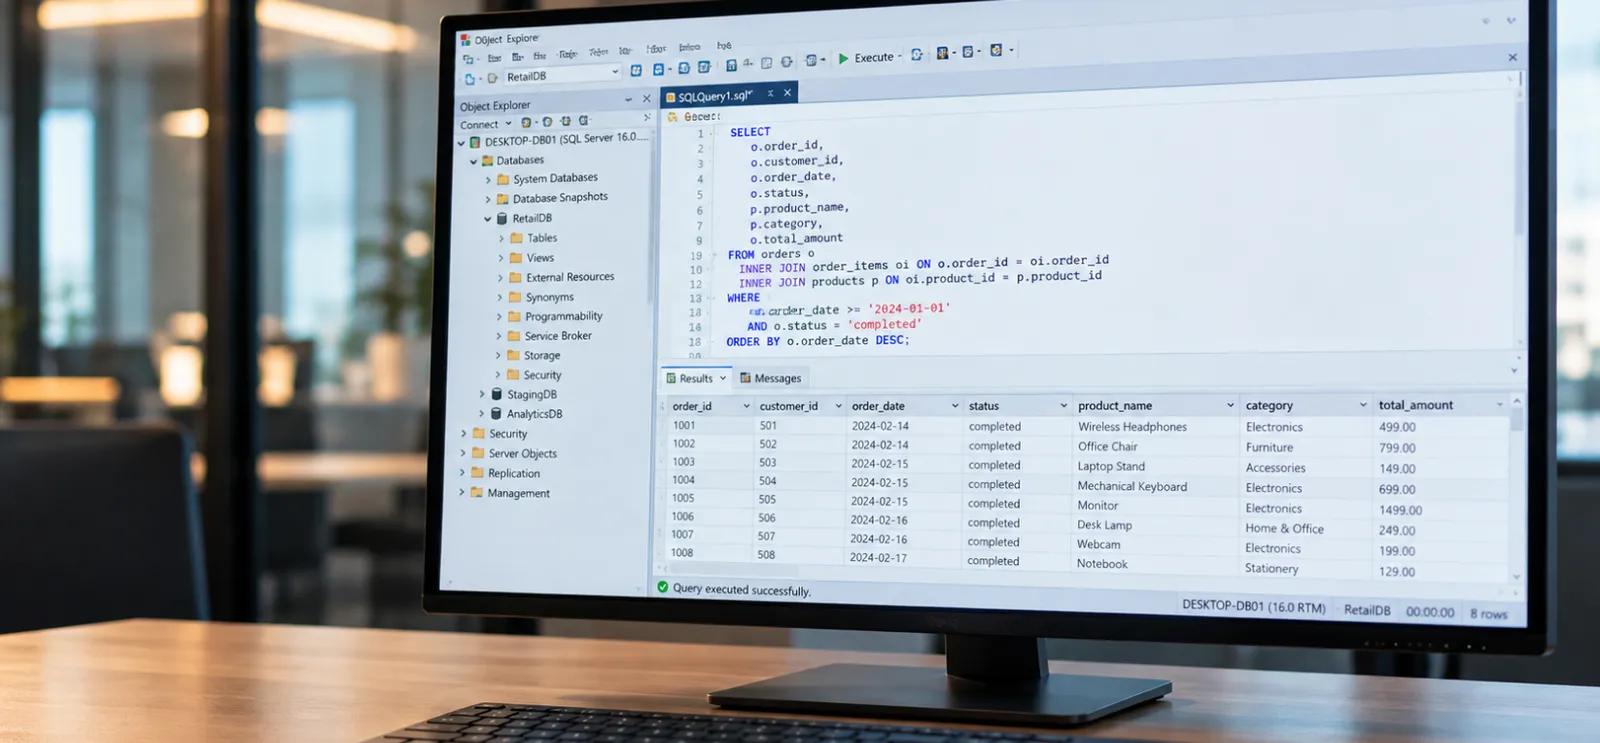
// The Hidden Cost of Data Decay.
The Garbage-In, Garbage-Out Trap
Feeding poor data into AI models produces hallucinations, biased decisions, and broken analytics. The quality of your AI is inseparable from the quality of your data.
The Migration Gap
60% of data migrations fail due to poor validation, resulting in lost records, broken relationships, and months of silent corruption before detection.
The Compliance Shadow
Inaccurate data isn't just a technical bug, it's a GDPR and regulatory liability. Bad data in production can trigger audit failures, fines, and eroded trust.
Jignect transforms data validation from a manual spot-check into a continuous, AI-driven engineering discipline.
// Data Integrity Coverage Across Every Pipeline Stage and Database Layer
ETL/ELT Pipeline Validation
ETL testing services with row-level validation of extract, transform, load logic, verifying data stays intact moving into warehouses like Snowflake, BigQuery, and Databricks.
Data Migration & Parity Validation
Data migration testing with automated reconciliation between source and target: 100% record count parity, field-level comparison, and truncation detection.
Schema Evolution & Change Management
Tracking schema changes across versions, validating column and type changes without breaking downstream dependencies.
Data Quality Rule Validation
Enforcing business rules: completeness, uniqueness, referential integrity, and cross-table consistency checks.
Database Performance & Query Validation
Query execution plan analysis, index utilization, and slow query detection at production data volumes.
Streaming & Real-Time Data Validation
Kafka and Spark streaming job validation: message ordering, deduplication, and processing latency under load.
AI Training Data Validation
Dataset completeness, label distribution, feature drift detection, and bias analysis, because your AI quality starts with data quality.
Data Privacy & PII Masking Validation
Validating masking and anonymization protocols in non-production environments, keeping PII obfuscated while preserving statistical usefulness.
Cross-Database Consistency
Synchronization validation across SQL, NoSQL, and cloud warehouse tiers, ensuring consistency across replicas and reporting databases.
Synthetic Data Engineering
High-fidelity synthetic datasets that mirror production complexity without security risk, for AI training and large-scale regression.
// Four Ways AI Transforms Data Validation From Reactive to Predictive
AI Database Fingerprinting & Baseline Discovery
AI catalogs schemas, constraints, and cross-table relationships in minutes, producing a baseline manual documentation would take weeks to assemble.
Anomaly Detection Across Large Datasets
AI detects statistical outliers and distribution shifts that rule-based validation misses, an early warning before bad data reaches downstream AI models.
AI-Driven Change Impact Prediction
Before any schema change, AI analyses dependency chains to predict which tables and applications will be affected, enabling pre-emptive fixes.
Continuous Drift Detection Engine
Real-time alerts when production data drifts from established baselines, so quality issues are caught in minutes, not months.
// AI-Driven Data Validation Across the Full Data Lifecycle
Data validation isn't a single test at the end of a migration. It's a continuous discipline covering design, pipeline execution, migration, and production monitoring. Here's how Jignect structures it:
Baseline Discovery & AI Fingerprinting
//01AI maps schemas, constraints, and data distribution across source systems, establishing the baseline fingerprint every future state is compared against.
Change Impact Analysis & Risk Assessment
//02Before a migration or pipeline change, we predict downstream breakage and identify which tables, reports, and applications are at risk.
Row-Level & Statistical Validation
//03Deterministic rule checks combine with AI-powered statistical sampling to detect distribution shifts and anomalies at scale.
Pipeline Execution Monitoring
//04ETL/ELT pipelines are instrumented with real-time quality gates, catching transformation errors before they propagate to the target layer.
Migration Reconciliation & Sign-Off
//05Post-migration automated reconciliation at record and relationship level produces an audit-ready report showing parity or itemized discrepancies.
Drift Detection & Production Observability
//06Continuous monitoring post-go-live alerts on unexpected distribution shifts, schema drift, and pipeline performance degradation.
// Tool Coverage Across Every Database Type and Pipeline Architecture
// Documentation That Makes Data Quality Auditable
Baseline Data Fingerprint
The AI-generated schema, constraint, and distribution baseline every future state is compared against.
Discrepancy & Reconciliation Report
100% parity confirmation or an itemized list of exactly which records and fields differ, and why.
Risk Assessment & Remediation Plan
Findings ranked by business impact, with concrete remediation steps your team can action immediately.
Drift Monitoring Setup
Post-migration alerting rules and dashboards so data quality stays visible long after go-live, not just at the point of validation.
// Latest Articles.
// Questions, Answered.
What is the difference between data validation and database testing?
Data validation QA focuses on accuracy, completeness, and consistency: ensuring records are correct and business rules are upheld. Database testing is broader, covering functionality, performance, security, and recovery. As data testing services go, validation is one component of comprehensive database testing, targeting data integrity specifically rather than system behavior.
How do you validate data migrations without impacting production systems?
We use non-invasive techniques: shadow traffic analysis, logical replication for real-time sync, and isolated test environments that mirror production volume and structure. Validation runs against copies or staging systems, never live production writes, ensuring zero impact.
Can you validate streaming and real-time data pipelines (Kafka, Spark)?
Yes. We instrument streaming pipelines with inline quality gates validating message schema compliance, ordering, deduplication, and latency in real time, surfacing anomalies like out-of-order events with millisecond precision.
How do you validate AI training data quality?
We assess dataset completeness, label distribution balance, detect feature drift as input distributions change over time, trace data lineage back to every training example's origin, and run bias analysis to identify demographic or contextual skew.
What is synthetic data engineering and when should we use it?
Synthetic data engineering generates high-fidelity artificial datasets that mirror production complexity, same schema, relationships, and edge cases, without real customer data. Use it for load testing at scale, large-scale regression testing, and AI training without exposing sensitive data.
How do you handle PII and data privacy in non-production test environments?
We implement masking, replacing sensitive values with obfuscated but consistent replacements, and anonymization that removes direct identifiers while preserving statistical properties. Validation confirms PII is correctly hidden across every test environment, using differential privacy techniques so test data can't be reverse-engineered.
How do you make data validation continuous in a CI/CD pipeline?
We embed validation gates into CI/CD as separate stages: schema validation on every commit, ETL tests on pull requests, and production validation post-deployment. Failures block deployment, making data quality a persistent signal rather than a one-time check.
What deliverables do we receive after a data validation engagement?
A comprehensive validation report: baseline data fingerprint, itemized discrepancy analysis, risk assessment, remediation recommendations, audit-ready sign-off documentation, and post-migration drift monitoring setup with alerting rules and dashboards.